図 3 仕事での生かし方仕事での生かし方 1
データ分析・AI
機械の記録や注文のデータから傾向を読み取り、異変の発見や需要の予測、AI の開発に生かす仕事です。数学 I の標準偏差や数学 B の数列が、そのまま仕事の道具になります。
ひとことで言うと
体温計の「いつもと違う」に気づく
朝の体温が 36.2 度の人もいれば、36.8 度の人もいます。大事なのは、その人の「いつも」からどれだけずれているかです。データの仕事は、この「いつもとの違い」や「これからの動き」を、何百万件もの記録から数学を使って読み取るものです。
01
どんな仕事?: 記録の中から、役に立つ発見を探す
データサイエンティストは、売上やアクセス、機械のセンサーなどの記録を分析し、仕事の判断に役立つ発見を探します。機械学習エンジニアは、データから見分け方や予測のしかたを学ぶ AI をつくり、サービスに組み込みます。
どちらの仕事でも、最初に使うのは高校の数学です。平均や標準偏差で記録の特徴をつかみ、散布図で 2 つの量の関係を調べます。偶然かどうかは確率で考え、言葉や画像は数の並び(ベクトル)にして計算します。
このページでは、数学 I の標準偏差で「いつもと違う」を見つける方法と、数学 B の数列で来週の注文の数を予測する方法を紹介します。どちらも、教科書で習う計算がそのまま使われている場面です。
高校の数学の単元の多くが、データの仕事の道具箱に入っています。
図解データの仕事で使う高校の数学
- 平均・標準偏差記録のふつうの範囲をつかむ(数学 I)
- 散布図と相関2 つの量の関係を調べる(数学 I)
- 数列・漸化式記録を積み重ねて予測する(数学 B)
- 正規分布ずれの大きさを割合で読む(数学 B)
- ベクトル言葉や画像を数の並びにする(数学 C)
- 微分AI の誤差が減る向きを探す(数学 II)
02
標準偏差が生きる場面: 「いつもと違う」を見つける
工場では、同じ部品を何万個もつくります。機械がどれだけ正確でも、部品の重さや長さは少しずつばらつきます。困るのは、ふつうのばらつきにまぎれて、機械の調子が悪くなった兆しが見えにくくなることです。
1924 年 5 月 16 日、アメリカの電話機器の工場で働いていたシューハートが、上司に短いメモを出しました。記録を時間の順に点で打ち、ふつうのばらつきの範囲に線を引いて見張る「管理図」の提案です。線の外に出た点は、偶然ではない原因があるかもしれない合図になります。
線を引く位置には、数学 I で学ぶ標準偏差を使います。管理図では、平均から標準偏差の 3 倍の位置に線を引くのが基本です。データが正規分布に従うなら、偶然だけで線の外に出るのは約 0.3%、およそ 370 回に 1 回です。
いまは、工場の機械のセンサーやサーバーへのアクセスの記録を、コンピュータが休まず見張っています。しくみは複雑になりましたが、「ふつうのばらつきを数で決め、そこから外れたものに気づく」という考え方は、100 年前の管理図と同じです。
標準偏差で「ふつうの範囲」を決めると、異変に早く気づけます。
図解部品の重さを管理図で見張る(例)
- 1標準偏差の 3 倍は 0.2 × 3 = 0.6 g
- 2上の線は 50.6 g、下の線は 49.4 g に引く
- 3毎時間、部品を取り出して重さを点で打つ
- 450.7 g の部品が出て、上の線をこえた

03
数列が生きる場面: 来週の注文の数を、重みをつけて予測する
工場では、来週どれだけ部品の注文が来るかを予測して、材料や人の手配を決めます。予測の方法の 1 つが、過去の記録に重みをつけて平均する「指数平滑法」です。新しい記録ほど重く、古い記録ほど軽く数えます。
計算は、数学 B で学ぶ漸化式そのものです。「来週の予測 = α × 今週の実績 + (1 − α) × 今週の予測」をくり返します。α は 0 と 1 の間の数です。たとえば α = 0.5 で、今週の予測が 100 個、実際の注文が 120 個だったとします。来週の予測は 0.5 × 120 + 0.5 × 100 = 110 個です。
この式をさかのぼって展開すると、記録につく重みが見えてきます。今週は α、先週は α(1 − α)、その前は α(1 − α)² と、重みが等比数列になって並ぶのです。α = 0.5 なら 0.5、0.25、0.125… です。数学 III の無限等比級数で足すと、重みの合計はちょうど 1 になり、きちんとした平均になっていると分かります。
新しい記録が届くたびに、前の予測を 1 回直すだけで済むのも強みです。何千種類もの部品の予測を毎週くり返す仕事でも、計算が軽くて済みます。α を大きくすると最近の変化にすばやく反応し、小さくすると落ち着いた予測になります。
漸化式と等比数列が、毎週の予測をすばやく更新するしくみを支えています。
04
工場のデータを見張るデータサイエンティストの 1 日(例)
ここでは、部品をつくるメーカーで、工場のデータの分析を受け持つデータサイエンティストの 1 日の例を紹介します。
朝は、夜の間に集まったセンサーの記録を確かめます。管理図の線をこえた点があれば、工場の担当者に連絡して、機械の点検を相談します。線が厳しすぎると、問題のない機械まで止めてしまうので、線の位置の見直しも仕事のうちです。
午後は、来週の注文の予測を見直します。予測と実際の注文がどれだけずれたかを部品ごとに調べ、ずれの大きい部品は α の値や予測の方法を変えて試します。分かったことは、数式を使わずに、グラフと言葉で現場の人に伝えます。
数字の異変に気づき、現場と一緒に原因を確かめるのが仕事の中心です。
図解工場のデータを見張るデータサイエンティストの 1 日(例)
- 8:30記録の確認夜の間のセンサーの値を見る
- 9:30現場と相談線をこえた機械の点検を決める
- 11:00線の見直し標準偏差を計算し直す
- 12:00昼休み
- 13:00予測の点検予測と実際の注文のずれを見る
- 15:00方法の改良α の値を変えて試す
- 17:00報告グラフにして工場の人に伝える
05
向いている人と入り方・その先
高校のうちは、数学 I の「データの分析」と数学 B の「数列」「統計的な推測」を大切にしてください。標準偏差や正規分布、漸化式は、仕事で毎日のように使います。数学 C のベクトルと数学 II の微分は、AI のしくみを学ぶときの土台になります。
大学は、情報系や数学・統計の学科のほか、データサイエンスを看板にした学部も選べます。文部科学省は、大学などの数理・データサイエンス・AI の教育プログラムを認定する制度を設け、2021 年度から認定を始めました。認定の一覧で、志望校にどんな授業があるかを調べられます。
数字の小さな変化に気づける人、「なぜ?」を確かめずにいられない人に向いています。経験を積むと、分析チームのリーダーや AI の開発の責任者、研究の仕事へ進む道があります。データを分析する仕事は、メーカーや IT の会社だけでなく、金融や鉄道、スポーツなどにも広がっています。
高校の統計と数列が、そのまま大学と仕事の入口になります。
図解高校からデータの仕事への道(例)
- 1高校で学ぶデータの分析・数列・統計
- 2大学で深める統計学・機械学習・プログラミング
- 3会社に入る分析や AI の開発の部署へ
- 4専門を広げるチームのリーダーや研究の道へ
高校生のうちに試せること
通学時間で「いつもと違う日」を探す
3 週間、毎日の通学にかかった時間を記録しましょう。表計算ソフトで平均と標準偏差を出し、平均から標準偏差の 2 倍以上ずれた日を探します。雨やダイヤの乱れなど理由を書き出すと、管理図の考え方が実感できます。
指数平滑法で明日の気温を予測する
表計算ソフトに 2 週間分の最高気温を入れ、α = 0.3 と α = 0.7 の 2 通りで、次の日の予測を漸化式で計算しましょう。実際の気温と比べて、どちらの α がよく当たるかを確かめてください。
データサイエンスを学べる大学を調べる
文部科学省のページには、数理・データサイエンス・AI の教育プログラムに認定された大学・短大・高専の一覧があります。気になる大学を探し、どんな授業があるかを大学のサイトで確かめましょう。
認定・選定校一覧(文部科学省)
「データ分析・AI」に関連するコミュニティ
研究室・部活・サークルなど、全国の 59 件から探せます。
統計モデル学
岡山大学(岡山県)
工学部 情報・電気・数理データサイエンス系 数理データサイエンスコース・統計科学・坂本 亘 教授
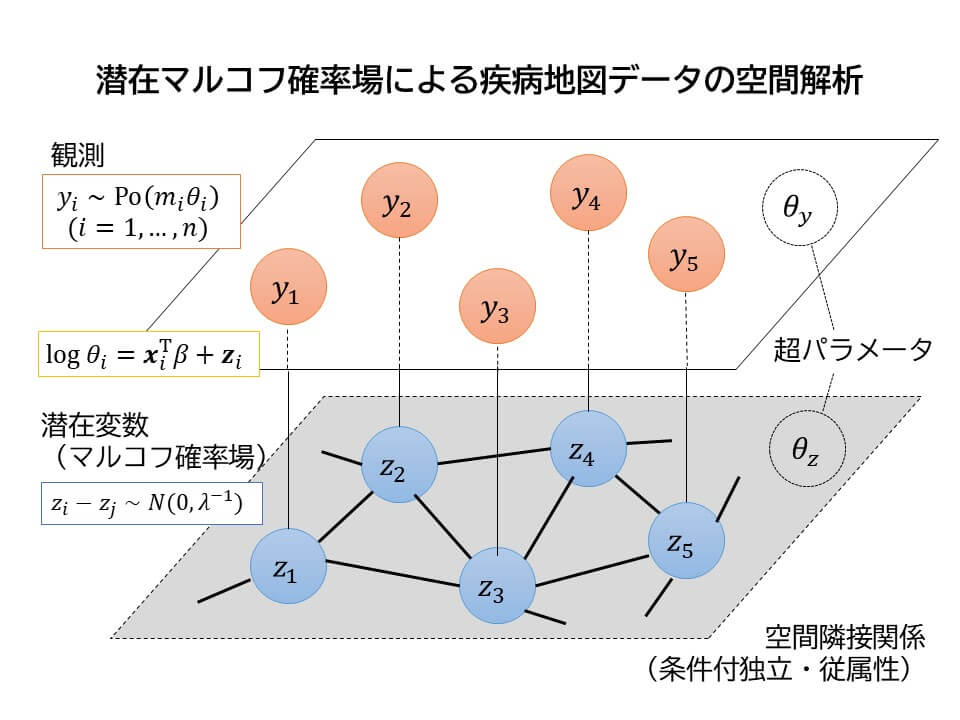
環境・生命科学データの解析に使う統計モデルと、最適なモデルを選ぶ方法を研究する。
杉山研究室
東京大学(東京都)
情報理工学系研究科コンピュータ科学専攻・機械学習・統計的データ解析・杉山 将 教授
中井研究室
東京大学(東京都)
情報理工学系研究科システム情報学専攻・非侵襲脳機能計測・MRI・機械学習・中井 智也 准教授

データ解析・モデリング
広島大学(広島県)
先進理工系科学研究科 情報科学プログラム・情報科学・江口 浩二 教授
深層学習、ベイズ統計・ベイズモデリング、モデル選択などを研究している。
多変量データ解析学
岡山大学(岡山県)
工学部 情報・電気・数理データサイエンス系 数理データサイエンスコース・統計学・高岸 茉莉子 講師
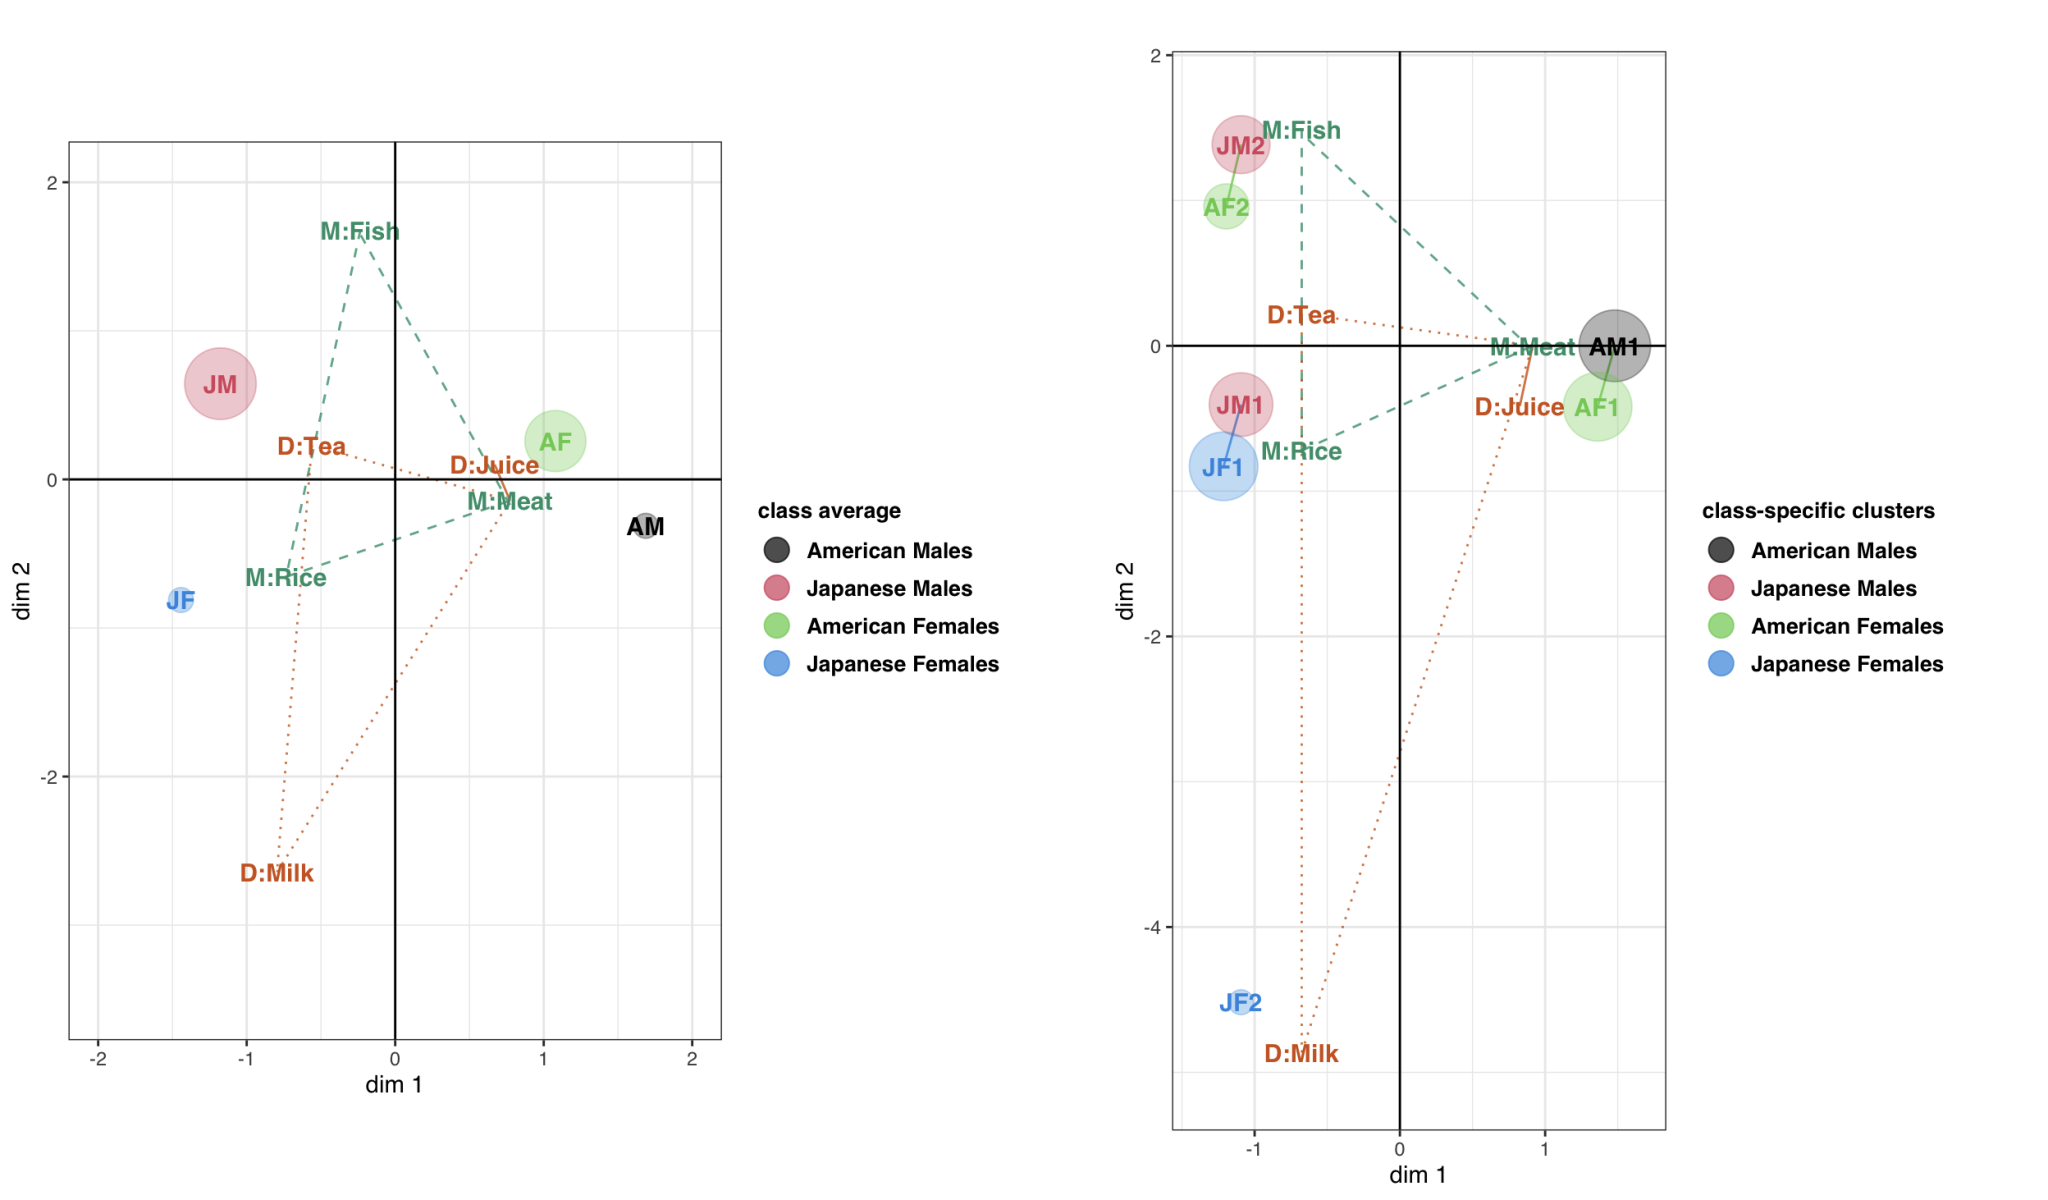
大規模で複雑なデータから有用な情報を取り出す多変量解析や機械学習の手法を開発する。
熊坂研究室
東京大学(東京都)
情報理工学系研究科コンピュータ科学専攻・遺伝統計学・応用統計学・熊坂 夏彦 教授

よくある質問
数学が苦手でも、データの仕事を目指せますか?
目指せます。最初に必要なのは、平均・標準偏差・散布図など、数学 I の「データの分析」の内容です。自分の身近な記録で計算してみると、式の意味がつかみやすくなります。大学では、プログラムで計算しながら統計を学ぶ授業もあります。
文系の学部からでも、データの仕事に就けますか?
就けます。経済学や心理学、社会学でも、データを集めて統計で確かめる授業があります。プログラミングや統計を自分で学び足すと、分析の仕事に進みやすくなります。どこまで学べるかは大学によって異なります。
AI が進むと、データの仕事はなくなりませんか?
計算そのものはコンピュータが行いますが、どのデータを使うか、結果が正しいかを判断するのは人です。管理図の線の位置や予測の α のように、現場の事情に合わせて決める部分も多く残ります。
出典
- M Best・D Neuhauser「Walter A Shewhart, 1924, and the Hawthorne factory」(Quality & Safety in Health Care、2006 年)
- NIST/SEMATECH e-Handbook of Statistical Methods「What are Variables Control Charts?」
- NIST/SEMATECH e-Handbook of Statistical Methods「Single Exponential Smoothing」
- 文部科学省「数理・データサイエンス・AI 教育プログラム認定制度」